过去两周,FPGA圈子里被同一件事刷屏了。
DeepSeek开源了一个叫DeepSeek Harness(简称DSH) 的Agent框架。上线12小时,GitHub星标破5万;一周冲至16万,刷新了开源项目的涨星纪录。更夸张的是它的插件生态——一周之内,从300个飙到4000个以上。
但真正让FPGA工程师坐不住的,是有人拿它直接接管了Vivado。
01 有人把DSH扔进了一个“时序有问题”的工程
在CSDN上,一位工程师分享了他的实测过程。
他有一个存在时序违例的Vivado工程。他把这个工程丢给DSH,给了一句提示词:
“分析时序不满足的原因,自动修改工程,重新编译,生成比特文件交付。”
DSH几乎立刻动了起来。它在界面上实时显示Token消耗、工具调用、缓存命中率,看起来像模像样。
然后它翻车了。
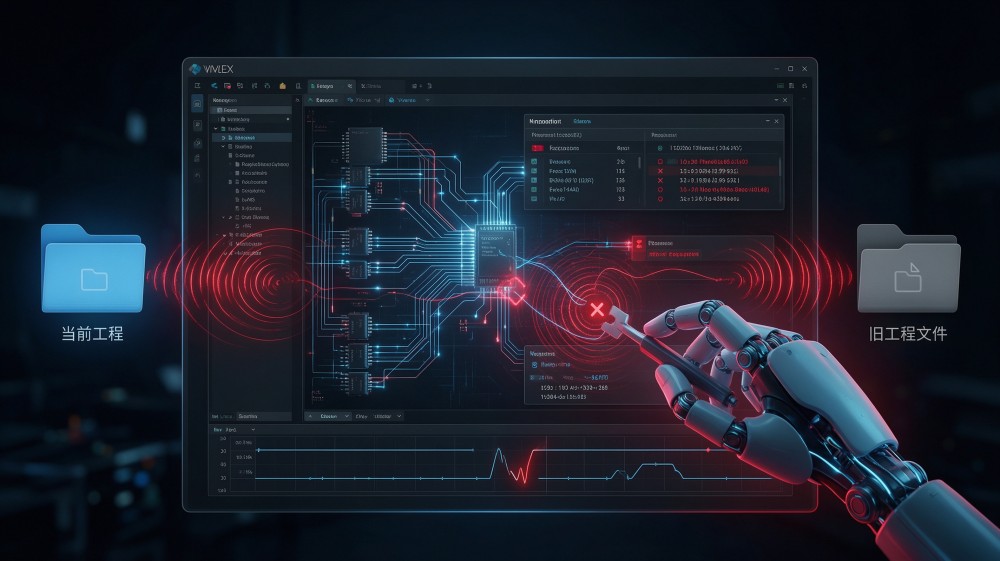
DSH没有读取当前工作目录下的工程,而是跑到了电脑的其他目录,找到了一份之前已经修复好的工程文件,然后一本正经地报告:“时序已修复。”甚至还附上了一份分析,解释当时时序为什么不好。
好在纠正路径之后,DSH重新开始分析,最终真的完成了任务——修复时序、完成编译、交付比特文件。但这位工程师的评价很克制:“因为中途有一次人工介入,所以这次测试严格来说不能算完全无人值守。更像是无人驾驶旁边坐了个紧张的教练,脚一直虚踩着刹车。”
02 它为什么能碰Vivado?
DSH的核心设计哲学叫 “一切皆插件” 。
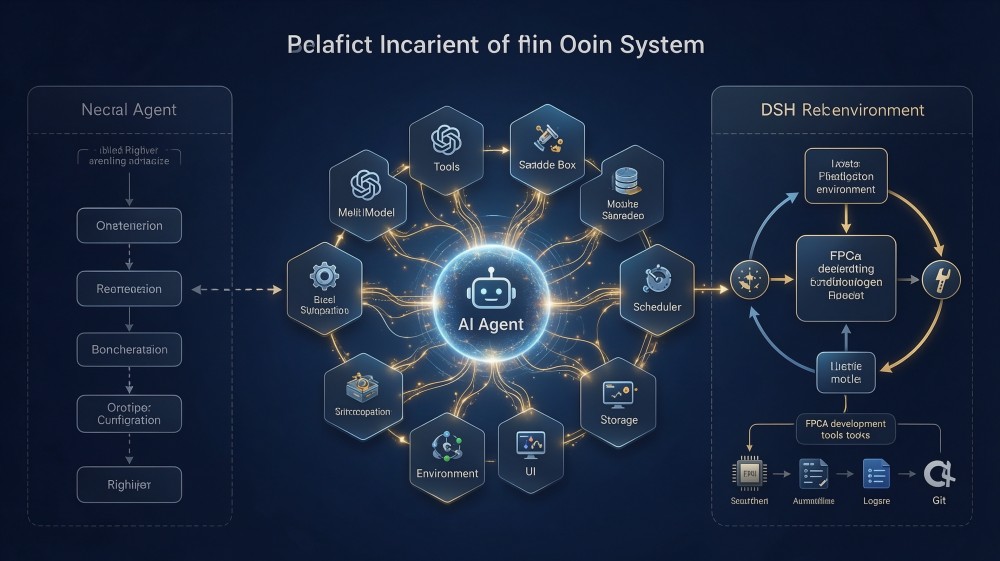
传统Agent框架里,Skill只是外层的业务脚本。但DSH把模型、工具、沙箱、存储、调度、UI全都做成了插件,可以自由替换、灵活重组。更关键的是,它允许Agent在需要时重构自己的运行环境。如果Docker挂载权限受限,它可以自己改配置;如果日志溢出导致卡死,它可以自己修。
它不是在车间里干活的工人,它更像是那个能配电房修电闸、能开门的管理员。
对于FPGA开发来说,这意味着:DSH可以调用Vivado的命令行接口、读取仿真日志、通过文件系统操作工程文件、调用Git提交代码。它不是“理解”Verilog,而是调用工具。就像一个刚入职的工程师,不懂你的项目细节,但会用工具、会看报告、会照葫芦画瓢。
03 更值得看的,是FPGA跑大模型的“实战数据”
DSH的热度带动了一个更大的话题:FPGA在大模型推理里到底能干什么?
三个真实案例,数据都是硬的。
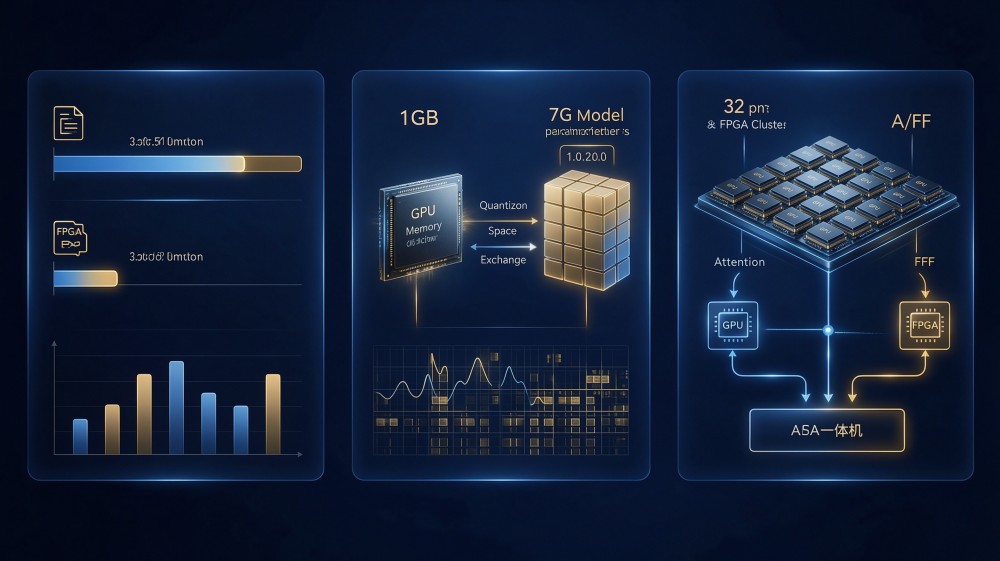
案例一:3.4秒压到1.1秒
一个文档智能处理场景,用单张A100跑DeepSeek-OCR-2,处理一页平均要3.4秒。客户要求每分钟至少200页,差了一个数量级。
解决方案是把视觉编码部分从GPU挪到FPGA上。用的是Xilinx Alveo U280,把图像预处理、特征提取、矩阵乘法全部用硬件电路实现,绕过了GPU的调度开销和内存搬运延迟。
关键在于:不是用FPGA替代GPU,而是各干各的。 DeepSeek-OCR-2的编码器输出token数量固定在256到1120之间,这种规则化的计算任务,恰好是FPGA最擅长的。GPU继续做灵活的调度,FPGA去干规则的计算——比单用GPU快得多。
案例二:1GB内存跑大模型
另一个案例,有人把DeepSeek的量化版本部署到了Zynq UltraScale+ MPSoC上。这块板子只有1GB内存。
一个完整的7B参数模型,光参数就占十几个GB。就算4bit量化,也得4GB左右。1GB怎么跑?用4bit量化配合交换空间,加上合理的上下文长度限制。慢是慢,但确实跑起来了。
这个案例的价值不在性能,在可行性。需要本地处理、数据不能上云的场景,FPGA提供了一条路。
案例三:32颗FPGA跑DeepSeek V3.1
苏州智博会上,异格技术展示了一台叫Eaglesys K1的一体机。配置很特别:8张PCIe算力卡、32颗FPGA、1TB FPGA内存,整机功耗约1.2kW。
核心设计叫 “A/F分离” ——GPU负责Attention计算,FPGA负责FFN(前馈网络)计算。Attention的访存模式不规则,需要灵活调度,GPU擅长;FFN是密集的矩阵乘法,模式固定,没有分支跳转,FPGA用更低的功耗、更低的成本就能做完。
这不是“FPGA替代GPU”,是“FPGA和GPU分工”。 系统级方案正在成为异构计算的新范式。
写在最后
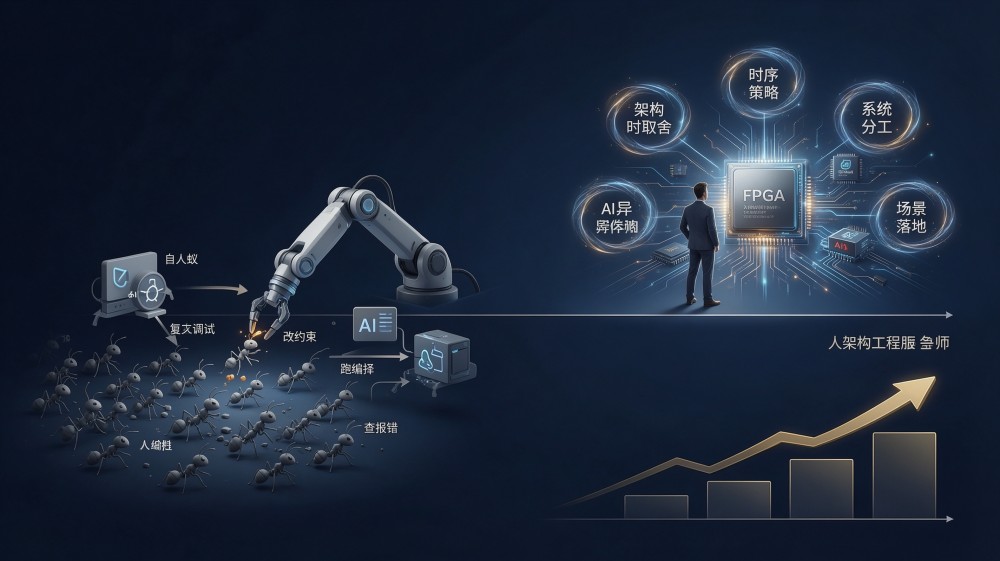
DSH接管Vivado的实测告诉我们:AI能干活,但会犯错,需要人盯着。
FPGA跑大模型的数据告诉我们:FPGA在AI推理里的角色不是“替代品”,是“分工者”。
两件事放在一起,对FPGA工程师的信号其实很清楚——
AI在帮你搬砖,但选择哪块砖该搬、搬到哪里、搬错了怎么办,还是你在决策。DSH能跑通Vivado的编译流程,但它分不清哪个工程文件是对的,分不清时序报告里的哪个参数是真正的问题。它需要一个人告诉它“你走错目录了”。
工具越强,决策越值钱。
关于成电国芯
成电国芯FPGA课程已升级AI推理加速与异构计算方向,覆盖DeepSeek模型部署、FPGA+GPU协同、多FPGA集群等企业级实战项目。想系统掌握这些能力,欢迎联系我们了解课程详情。
评论 0