你训练了一个不错的模型。准确率92%,参数量也控制得还行。
然后面试官问:“你这个模型,能在FPGA上部署吗?”
你卡住了。PyTorch到FPGA之间,隔着一条大多数人不知道怎么走的鸿沟。你知道要用Vitis HLS写C++内核,知道要做量化,知道要写AXI接口——但把这些全部串起来跑通,是一个学期都不一定够的工程量。
Free-TPU把这条鸿沟上的每一步,都铺好了。
它到底做了什么
Free-TPU是一个专为FPGA设计的开源AI处理器,在GitHub上获得275星、62次fork。它的定位很明确:让PyTorch、Caffe、Darknet、NCNN训练的模型,编译后直接部署到FPGA上。
支持的模型覆盖了从入门到进阶的完整谱系:LeNet、MobileNet、Squeezenet、Resnet、Inception V3、YOLO V3、ICNet。分类、检测、分割,全都能跑。
但真正让它有价值的,不是支持了多少模型,而是它把“部署”这件事从手写RTL变成了配置编译。
硬件上到底占多少资源
Free-TPU提供了多个硬件版本,对应不同的FPGA器件。以Zynq-7020(xc7z020-1) 为例,这是大多数高校实验室都有的板子:
| 资源 | 占用 |
|---|---|
| LUT | 62.96% |
| FF | 56.08% |
| BRAM | 80.00% |
| DSP | 73.18% |
FP16 MAC阵列规模为152个,工作频率100MHz。
如果你用更大的Zynq-7035,可以选528个MAC、200MHz的版本,资源占用降到LUT 28.89%、DSP 59.67%。
这些数字说明一件事:Zynq-7020跑得动,但资源用得很满。 这意味着你的设计必须精打细算,不能浪费任何一块BRAM或DSP。
从PyTorch到FPGA,到底要经过几步
Free-TPU配套了EEP-TPU SDK编译器,把整个部署流程压缩成了三步。
第一步:在PyTorch里训练模型,导出ONNX。
这一步和平时训练没有区别。你在PyTorch中定义网络、训练权重、导出ONNX格式。Free-TPU的编译器支持ONNX作为输入,不需要你手动把模型翻译成Verilog。
第二步:用TPU SDK编译。
这是最关键的一步。TPU SDK把ONNX模型编译成TPU架构可以识别和执行的格式。编译器会完成算子映射、内存分配和指令生成。你不需要手写任何硬件代码。
第三步:把编译产物部署到Zynq。
Free-TPU采用TPU与CPU协同工作的架构。ARM A9(Zynq的PS端)负责调度和预处理,TPU(PL端)负责神经网络推理。两者在深度学习推理框架的调度下交替工作,你可以控制交替的顺序和时机。
部署方式有两种: 通过SD卡加载模型权重,或者通过USB摄像头实时输入。配套的驱动库(EEPTPU_Library)和初始化函数(NNAPI)已经封装好了,你在ARM上写C++应用就能调用TPU进行推理。
一个真实的数据点
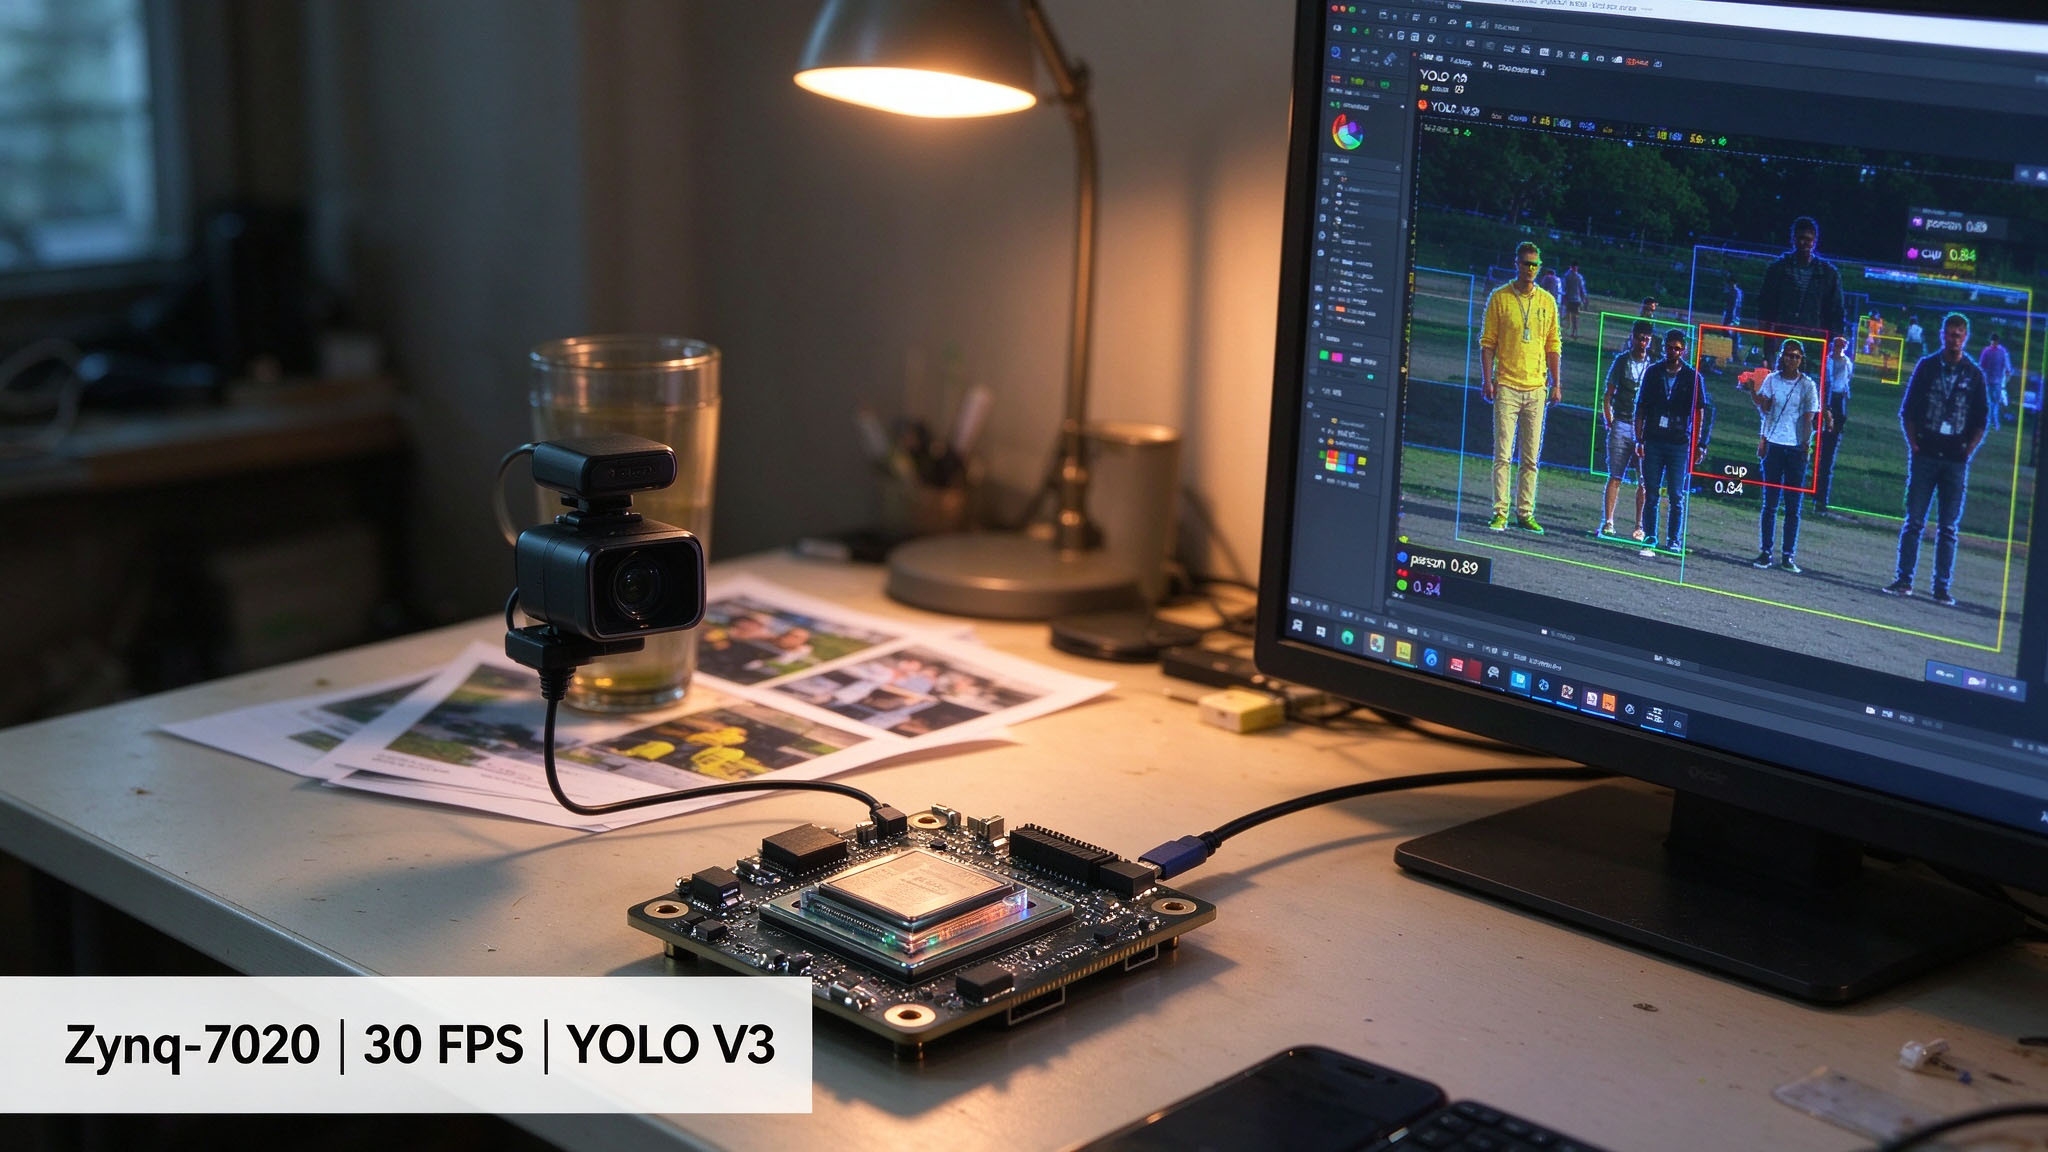
在Zynq-7020上,0.03T算力的EEP-TPU可以实现最高30 FPS的实时目标检测。
30 FPS是什么概念?这是“实时”的门槛。在这个帧率下,视频流是连续的,没有肉眼可见的卡顿。对于一个跑在百元级FPGA开发板上的AI加速器来说,这个数字说明Free-TPU不是Demo,是能跑真实负载的工程实现。
为什么Zynq-7020是“标准硬件”
大多数高校实验室都有ZedBoard或ZC702。这两块板子的核心都是Zynq-7020。
这意味着:你不需要额外买硬件。实验室角落里那块吃灰的开发板,插上USB摄像头,烧一个Free-TPU的比特流,就能跑起来一个完整的AI推理系统。
而且Zynq-7020的PS-PL架构天然适合“CPU+TPU”的协同模式。ARM核跑Linux,处理图像采集和结果展示;PL侧的TPU专心做推理加速。这种分工,正是工业界边缘AI系统的标准架构。
面试里能讲什么
如果你跑通了Free-TPU上的YOLO V3部署,面试官问“你做过FPGA AI加速吗”,你可以从这几个层面展开:
模型层面: 你在PyTorch中训练了什么模型?导出ONNX时遇到了什么算子兼容性问题?量化到INT8时精度掉了多少?
编译层面: TPU SDK是怎么把ONNX模型映射到TPU指令的?算子融合在编译阶段是怎么处理的?内存分配策略是怎样的?
硬件层面: TPU的MAC阵列规模是多少?片上BRAM够不够放权重?如果不够,怎么和DDR交互?CPU和TPU的调度是怎么协调的?
系统层面: 从摄像头输入到屏幕输出,端到端延迟是多少?瓶颈在图像预处理、推理、还是后处理?
这四个层面,每一个都可以讲五分钟。合起来就是一个完整的“从模型到硬件”的部署故事。
写在最后
Free-TPU不是一个能跑大模型的项目。152个MAC的算力,跑不了GPT。
但它的价值不在这里。它的价值在于:它把“AI模型部署到FPGA”这件事,从手写RTL的泥潭里拉了出来,变成了一套可以复现、可以调试、可以讲清楚的工程流程。
你在PyTorch里训练,在ONNX里导出,在TPU SDK里编译,在Zynq-7020上跑起来。每一步都有代码可查,每一个错误都有日志可看。
这是从“用AI”到“懂AI硬件”的那一步。
项目地址:github.com/embedeep/Free-TPU
评论 2