当所有人的目光都锁定在GPU的算力军备竞赛上时,一个反直觉的事实正在悄然改写AI芯片的权力版图——2026年,全球推理算力占AI算力总负载的70%-80%,而承接这一庞大推理需求的,不只是GPU,还有一种曾被视为”过时”的可编程芯片:FPGA。从通信基站里默默无闻的信号调度员,到自动驾驶域控制器中不可替代的实时决策核心,FPGA正在经历一场从”备胎”到推理算力主力的身份跃迁。一种诞生于上世纪80年代的芯片架构,凭什么在AI时代重新站上C位?
推理不需要”暴力算力”,需要”精准算力”
理解FPGA的逆袭,首先要理解GPU在推理场景中的结构性短板。
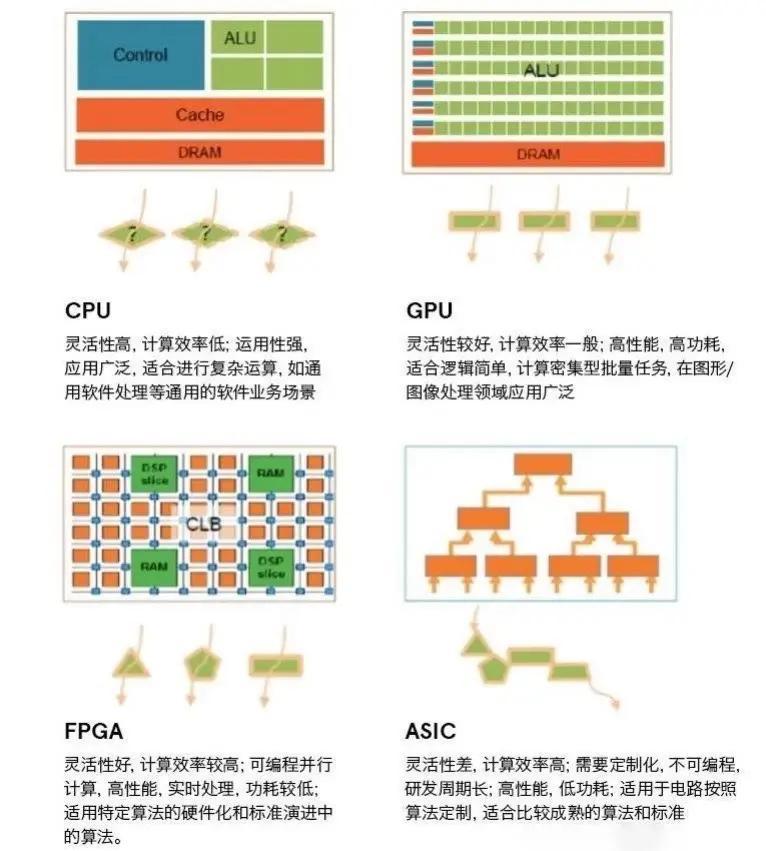
GPU的核心能力建立在大规模并行计算之上。数以千计的计算核心通过线程调度和指令流水线,在训练阶段处理海量矩阵运算时效率惊人。但推理场景的逻辑完全不同。推理是将已训练好的模型对新数据进行实时判断,它不需要”暴力吞吐”,需要的是确定性、低延迟和高能效。GPU在处理推理请求时需要不断分配线程、调度任务、管理内存搬运,这些软件栈层面的开销在训练时可以被算力规模摊薄,但在推理时却成为不可忽视的”隐性税”。
FPGA的工作模式恰好绕开了这一瓶颈。FPGA内部拥有海量可编程逻辑单元,每一个逻辑单元由查找表(LUT)和寄存器构成,能够直接将神经网络的计算图映射为硬件电路。数据一旦进入,便沿着固定的物理路径流动,无需指令解码、无需线程切换、无需软件栈调度。这种”硬件直连”架构带来三个决定性优势:
延迟层面,FPGA实现的是纳秒级硬件流水线响应,而GPU受限于软件调度,推理延迟通常高出一到两个数量级。在自动驾驶的障碍物检测、工业质检的实时缺陷识别等场景中,这一差距直接关乎安全与产线效率。
能效层面,FPGA按需激活逻辑资源,只有参与运算的模块才消耗功耗,而GPU即便在推理时也需要大量核心维持运转,功耗墙问题显著。在边缘设备功耗预算严格受限的条件下,FPGA的能效比优势被进一步放大。
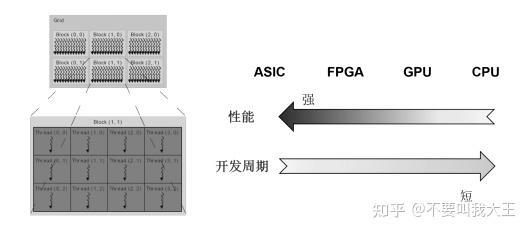
灵活层面,FPGA支持现场重配置。当AI模型迭代更新时,ASIC需要重新流片,周期长达数月、成本以千万计;而FPGA只需通过软件下载新的比特流,即可在数分钟内完成硬件逻辑的更新。这种”软硬一体”的敏捷性,在模型快速迭代的AI时代具有不可替代的价值。
推理不需要”暴力算力”,需要”精准算力”。这正是FPGA的主战场。
毫秒级响应:边缘AI的三大主战场
如果说推理算力的重心迁移是FPGA逆袭的”天时”,那么边缘AI的爆发则是它的”地利”。IDC数据显示,2026年第一季度全球边缘AI芯片出货量同比大增45%,其中面向IoT、工业边缘、智能终端的中低端AI芯片出货量涨幅突破110%。AI计算范式正从集中式训练与推理向分布式推理发生重大转移,而边缘场景对芯片的要求,几乎是为FPGA量身定制的。
自动驾驶的实时感知决策是最典型的战场。车载环境要求系统在毫秒级时间内完成传感器融合与目标检测推理,同时满足车规级功耗与极端温度约束。FPGA凭借硬件级低延迟和可重构特性,能够在域控制器中实现多传感器数据的并行预处理,将感知到决策的链路压缩到极致。安路科技基于国产28nm工艺的FPGA芯片已实现量产交付,其PH1P系列更通过了AEC-Q100 Grade 2车规认证并获得头部车企量产验证,这标志着国产FPGA已经具备切入这一高壁垒市场的能力。
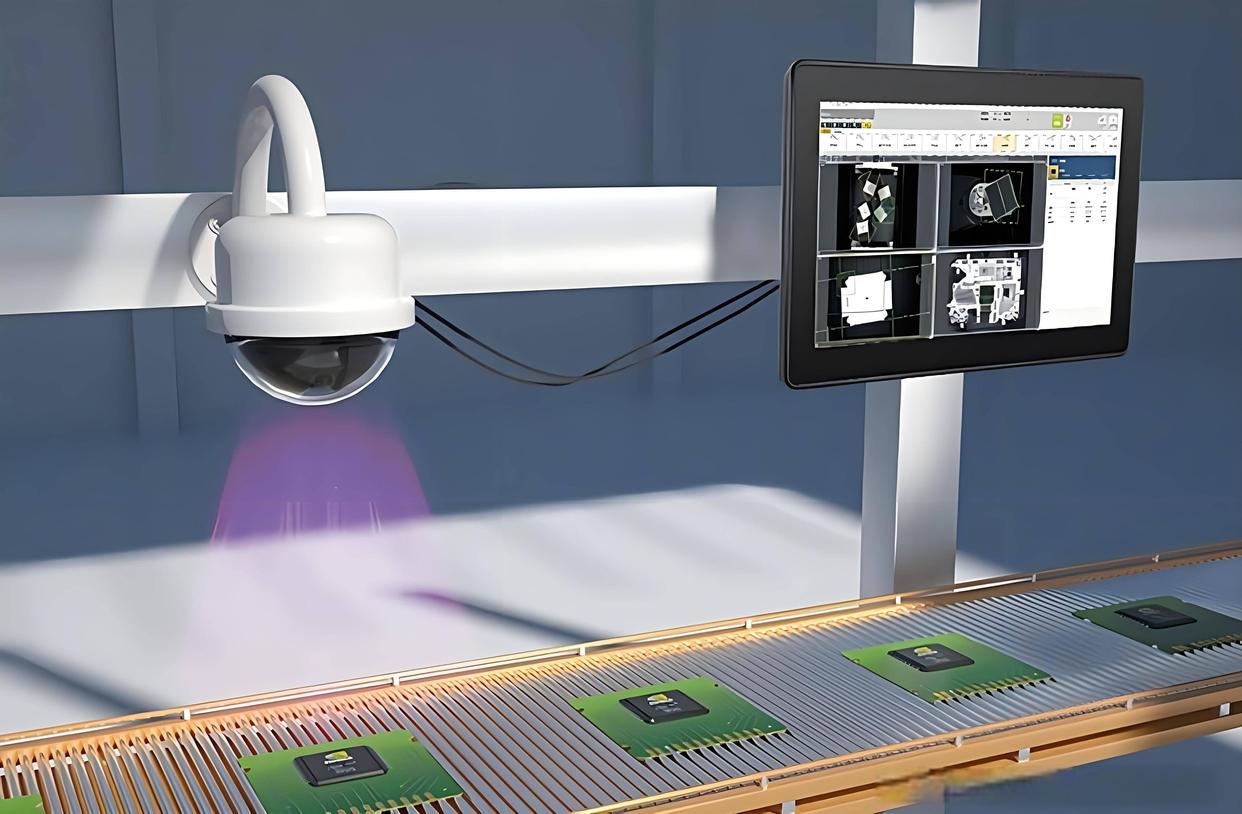
工业质检的产线级实时推理是另一个FPGA大显身手的领域。高速视觉检测需要在产线运转过程中实时识别缺陷,数据不能回传云端、不能有明显延迟。FPGA嵌入式部署在产线终端,直接完成图像推理,既降低了带宽依赖,又避免了网络抖动带来的不确定性。在通信设备制造商面临5G基站FPGA供货中断、工业自动化企业PLC和伺服驱动排产后延的当下,这种本地化推理能力的价值愈发凸显。
智能安防的端侧视频分析则展现了FPGA在功耗受限场景下的统治力。户外监控设备往往无散热条件、供电有限,却需要同时处理多路视频流的人脸识别与行为分析。FPGA在有限功耗下完成并行推理的能力,使其成为这类”无人值守”场景的理想选择。
三大场景的共性指向同一个结论:边缘AI的核心诉求——低延迟、低功耗、高可靠、可迭代——恰好是FPGA能力边界的精准覆盖区。
巨头落子:异构架构中的FPGA新坐标
FPGA的逆袭并非只是边缘市场的自发选择,更是产业巨头战略布局的结果。
AMD在2018年前后便洞察到FPGA在算力市场的价值,提出”数据中心优先”战略,随后推出自适应计算加速平台Versal。这一产品已脱离传统FPGA范畴,通过内部可编程引擎引入多个以自适应数据流方式组织的AI Core,作为承载数据密集型运算的主体。2025年11月发布的第二代Versal AI Edge系列,进一步将标量算力提升多达10倍,实现从预处理到推理再到后处理的端到端加速。Versal产品线的逻辑单元数高达1850万,采用台积电7nm FinFET工艺,代表着FPGA在高端市场的技术天花板。
Intel的路径则更具戏剧性。2015年以167亿美元收购Altera,十年后的2025年4月,却将Altera 51%的股份以87.5亿美元估值出售给银湖资本。这并非简单的”投资失败”,而是一次战略聚焦——Intel将资源集中于数据中心与汽车领域,Altera独立运营后推出Agilex 5 FPGA D系列和E系列,专门面向张量数学运算优化,内置专用DSP模块,明确瞄准AI推理加速。
更值得关注的是数据中心层面的架构演进。2026年已有多款AI服务器普遍采用”CPU+GPU+FPGA”三级异构架构:CPU负责系统管理,GPU专注大规模并行训练,FPGA则承担多颗GPU间的数据流通协调以及网络数据包的卸载预处理。FPGA之所以胜任这一角色,核心在于其”可重配置”能力——数据中心内部存在多种高速互联协议,不同厂商设备往往”语言不通”,FPGA通过在线升级即可随时改变协议解析逻辑,无需更换硬件就能适配新标准。
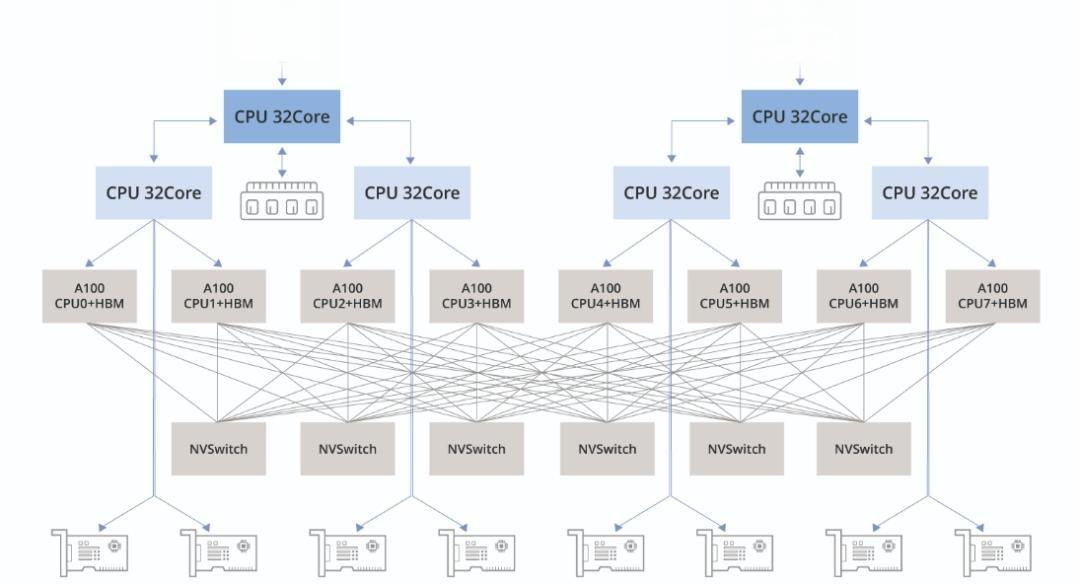
Gartner预测2028年80%以上的算力将用于推理而非训练,英伟达CEO黄仁勋更指出AI推理计算将增长10亿倍以上。当推理成为AI的绝对主场,单一芯片架构已无法满足全栈需求,异构计算成为数据中心标配。FPGA在推理层的不可替代性,正在被产业共识确认。
一个值得警惕的信号是供给端的收紧。赛灵思早在2025年便将70%-80%的先进产能转向高毛利AI专用FPGA,减少中低端产品供给;海外FPGA现货交期普遍拉长至52周。这意味着通用工业控制、通信基站等领域的缺口短期内难以弥合,也为国产FPGA的导入创造了窗口期。复旦微电、安路科技、紫光同创等国内厂商已在28nm至FinFET工艺节点实现覆盖,逻辑单元规模、SerDes速率等关键指标正持续逼近国际水平。当进口芯片的52周等待变成常态,缩短半年的交付时间本身就是巨大的商业价值。
FPGA的逆袭不是技术复古,而是AI从”训练为王”走向”推理为王”时代的必然选择。当算力的天平从峰值性能倒向能效比与延迟确定性,这种”可编程的精准”正在成为新的硬通货。在你所关注的领域里,究竟是算力峰值更重要,还是能效比与响应速度更关键?
评论 0